文章发出去十分钟,站内搜索还搜不到。清缓存、换关键词、直接调接口,都没有。
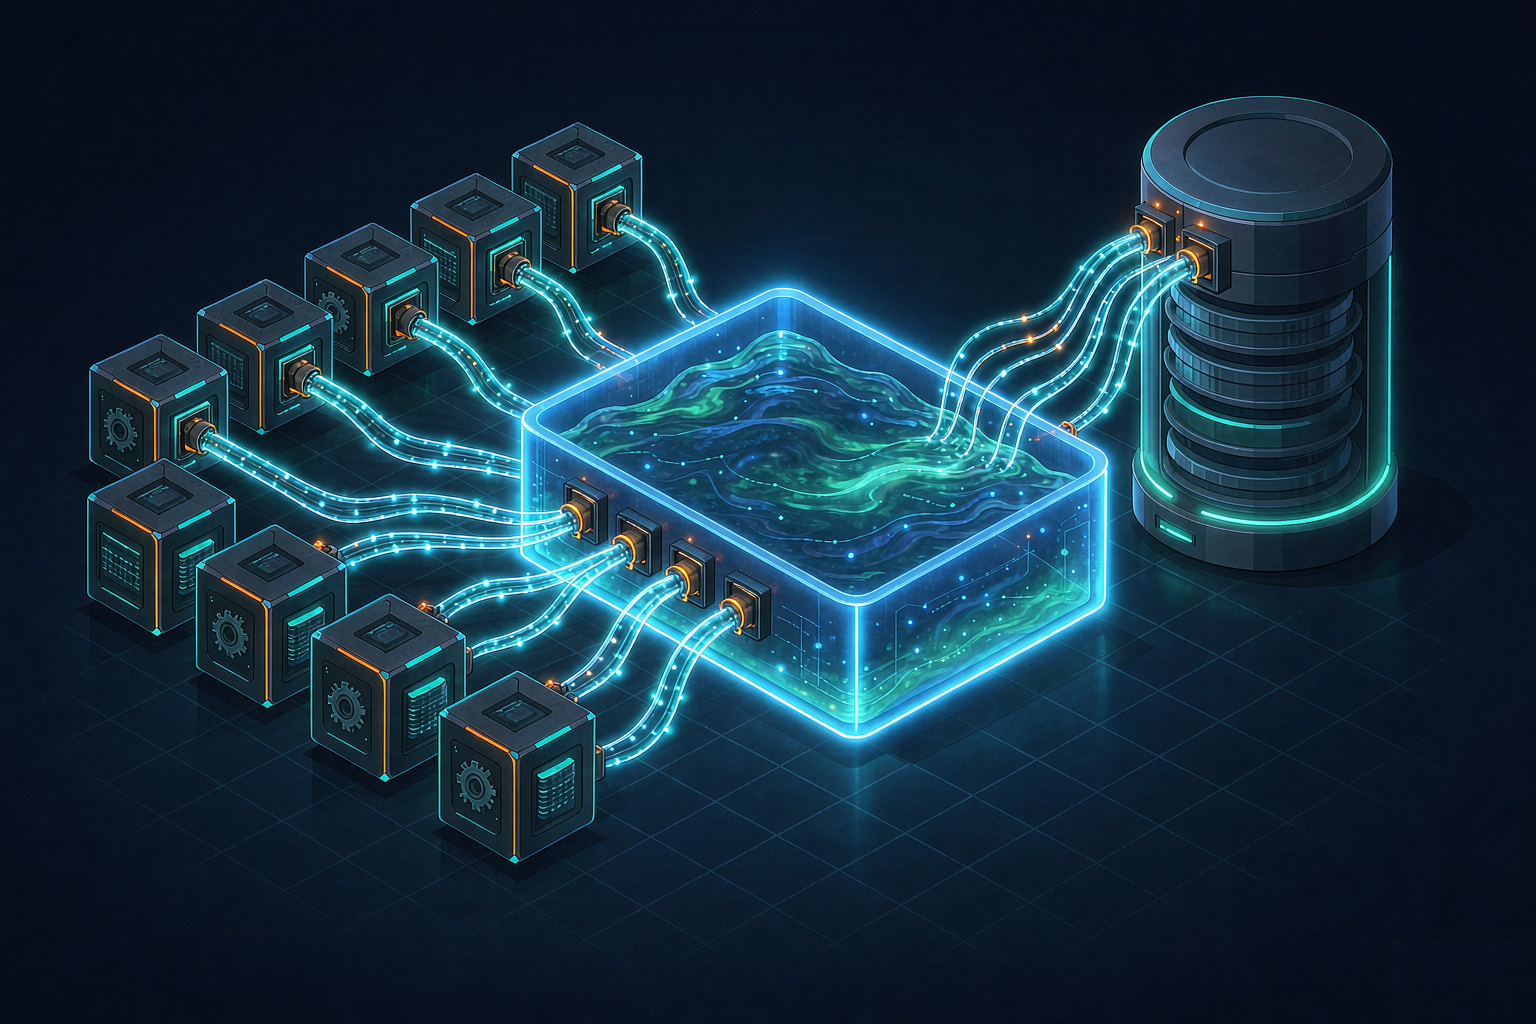
这不是搜索的问题,是同步的问题。把索引当成 MySQL 之外的第二份写入,只要中间隔着队列、隔着一次异常、隔着一段没跑完的批处理,两边就会分叉,而且大部分分叉当场不会报错。真正稳的做法不是把双写写得更用力,而是从一开始就承认它会对不上,另配一条能自己跑完的对账。
一行 config 是我被逼出来的
写这个博客的发布脚本时,里面有一行不在任何文档里的东西:
config(['queue.default' => 'sync']);
不是为了少装一个 Redis。是那天文章入库成功、页面 200、正文渲染正常,站内搜索死活搜不到。翻了半小时才发现:文章写完只发出去一个同步索引的作业,作业进了本地队列,而队列那一头没有 worker 在消费。它就那么排着,排到天荒地老。
这之后我加了两件事:发布脚本里强制 sync,以及验证清单里多一条「查索引表有没有这条记录」。第一条让这一次能成,第二条才是真正救命的,因为它不假设任何链路是通的,只看结果。
双写的断法比你想的多
真实世界里断的方式不止一种,随手能列出十条:
- 事务还没提交,消息先发出去了。消费者抢跑,按 id 去库里查,查不到,判定「已删除」,顺手把索引删了。
- 事务回滚,消息收不回来。索引里多一条不存在的数据。
- 队列重投,同一作业跑两遍。写操作幂等还好,遇上计数、累加类字段直接翻倍。
- 消费者自己报错,重试到上限,消息进死信队列,没人看。
- 灰度期间新旧两个消费者同时在跑,同一个文档的写入顺序错乱。
- 有人从后台改了一条数据,走的是另一个更新入口,那个入口忘了发消息。
- 批量导入或数据修复脚本绕过模型,直接 UPDATE。
- 索引服务临时不可用,重试几次后作业被丢弃。
- 双写成功了一半:MySQL 成功、索引超时,但 HTTP 层已经把 200 返回给用户了。
十条里有七条不报错。
这才是要命的地方。它不响,不告警,不进错误日志,你只在用户说「搜不到」的那天才知道它坏过,而且不知道坏了多久。
那我在事务里同步写索引呢
不行,而且比队列更糟。
一是事务里调外部服务,一次网络抖动就把整个业务事务拖到超时。索引服务的可用性直接变成发文章接口的可用性,这个耦合不该存在。
二是窗口变窄了,但没有消失。你在事务提交后同步写索引,中间还有个极窄的间隙:提交成功、写索引之前,进程被 OOM 掉了。窄不等于不存在,而这类间隙恰恰只在大促、重启、部署的时候出现。
三是延迟摆到了用户面前。走队列至少接口是快的,用户感知不到索引那 200ms。
见过不少项目把「一致性」直接理解成「同步」,最后换来的是接口 P99 翻倍、一堆重试逻辑,数据该丢还是丢。
binlog 是不是银弹
binlog 订阅(Canal、Debezium 那一套)真正解决的是「漏写」,不是「实时」。只要变更落到 MySQL,就一定会产生 binlog,绕过模型的 UPDATE 也能抓到。这一点比它的实时性值钱得多,因为上面那十条断法里,最难查的就是「有人走了另一个入口」。
但它不免费:
多一个中间件要运维,多一套账号权限要开,多一条会断的链路。binlog 的保留期有上限,消费位点落后超过保留期,那段变更就永久丢了,只能靠全量重刷兜底。而且它保证的是「变更不丢」,不是「索引正确」——你的映射逻辑改过一版,历史文档还是旧结构,照样要重刷。
所以我的判断:日活几万以下的站点,别上 CDC。为一个搜索框引入一套运维成本比你主业务还高的东西,不划算。等你手里已经有三四条类似的数据管道、运维这套是顺手的事,再上也不迟。
四种做法,各自的代价
| 方案 |
一致性 |
运维成本 |
什么时候选它 |
| 事务内同步双写 |
理论最强,实际最脆 |
低 |
几乎不要选 |
| 业务侧异步队列 |
最终一致,断法多 |
低 |
中小站点默认 |
| binlog 订阅 |
不漏变更,可能滞后 |
高 |
数据管道成熟、有值班 |
| 定时对账补偿 |
只保证收敛 |
中 |
前面三种都必须配 |
注意最后一行。对账不是二选一的方案,是前面三种的必备兜底。把对账当成可选项的项目,最后都在人工修数据。
对账得真的能跑完
对账不是「定时跑个全量」。一张百万行的表在业务高峰做全量比对,会把你数据库打歪,所以大部分人的全量对账脚本写完就没跑过第二次。
能长期跑的做法是分三层:
- 近实时窗口。每小时捞最近 2 小时 update_time 变化的记录做比对,量小,随时能跑。
- 每日抽样。随机抽 1% 的 id,比对存在性和关键字段,只报差异、不自动修,人看一眼。
- 每周全量。低峰期分批,每批五千行,批间 sleep,一条一条补。
关键不在跑,在于差异要有地方落。一张 sync_diff 表,记录 id、差异类型、发现时间、修复状态。没有这张表,你的对账脚本跑完就忘,等于没跑。
// 每小时窗口对账,简化版
$since = time() - 7200;
$rows = $db->select(
    'SELECT id, title, update_time FROM articles WHERE update_time >= ?',
    [$since]
);

foreach ($rows as $row) {
    $doc = $es->get('articles', (string) $row['id']);

    if ($doc === null) {
        $queue->push(new SyncArticleDoc($row['id']));
        $diff->insert($row['id'], 'missing');   // 索引里没有
        continue;
    }

    if ($doc['title'] !== $row['title']) {
        $queue->push(new SyncArticleDoc($row['id']));
        $diff->insert($row['id'], 'stale');     // 索引比库里旧
    }
}
这段代码有它自己的坑:$es->get 一条一条串行查,两小时窗口里如果有几万条变更,跑不完。要么批量 mget,要么把窗口调小。我一开始就是串行查的,第一次跑就超了半个钟头没结束,后来改成五十条一批 mget 才勉强能看。
什么情况下双写就够了
给你一个我自己在用的判定:索引丢了,业务会不会错?
博客的站内搜索挂了,用户搜不到一篇,他换个词或者直接翻列表页,业务不错。后台运营查不到某个商品,他会骂人,但不会记错账。这两种,双写加每小时对账完全够用,别再往上加东西。
但如果索引是订单查询的唯一入口、是风控命中的依据、是计费的基础,那它就不是「搜索」,是数据副本。数据副本得按数据副本的标准做:变更捕获、位点管理、可重放、可全量重建。到那时候讨论的重点已经不是双写要不要加队列,而是这套东西有没有人半夜能起来看。
最后
我现在的动作很土:文章发完不等页面刷新,先查一遍索引表。没记录就手动补一次作业,补不上就说明链路断了,当天修。这个习惯做了几个月,它没让任何一次故障消失,但它让故障每次都发生在用户之前。
双写这件事,最贵的不是写错。是写错了没人知道。


 技术随笔